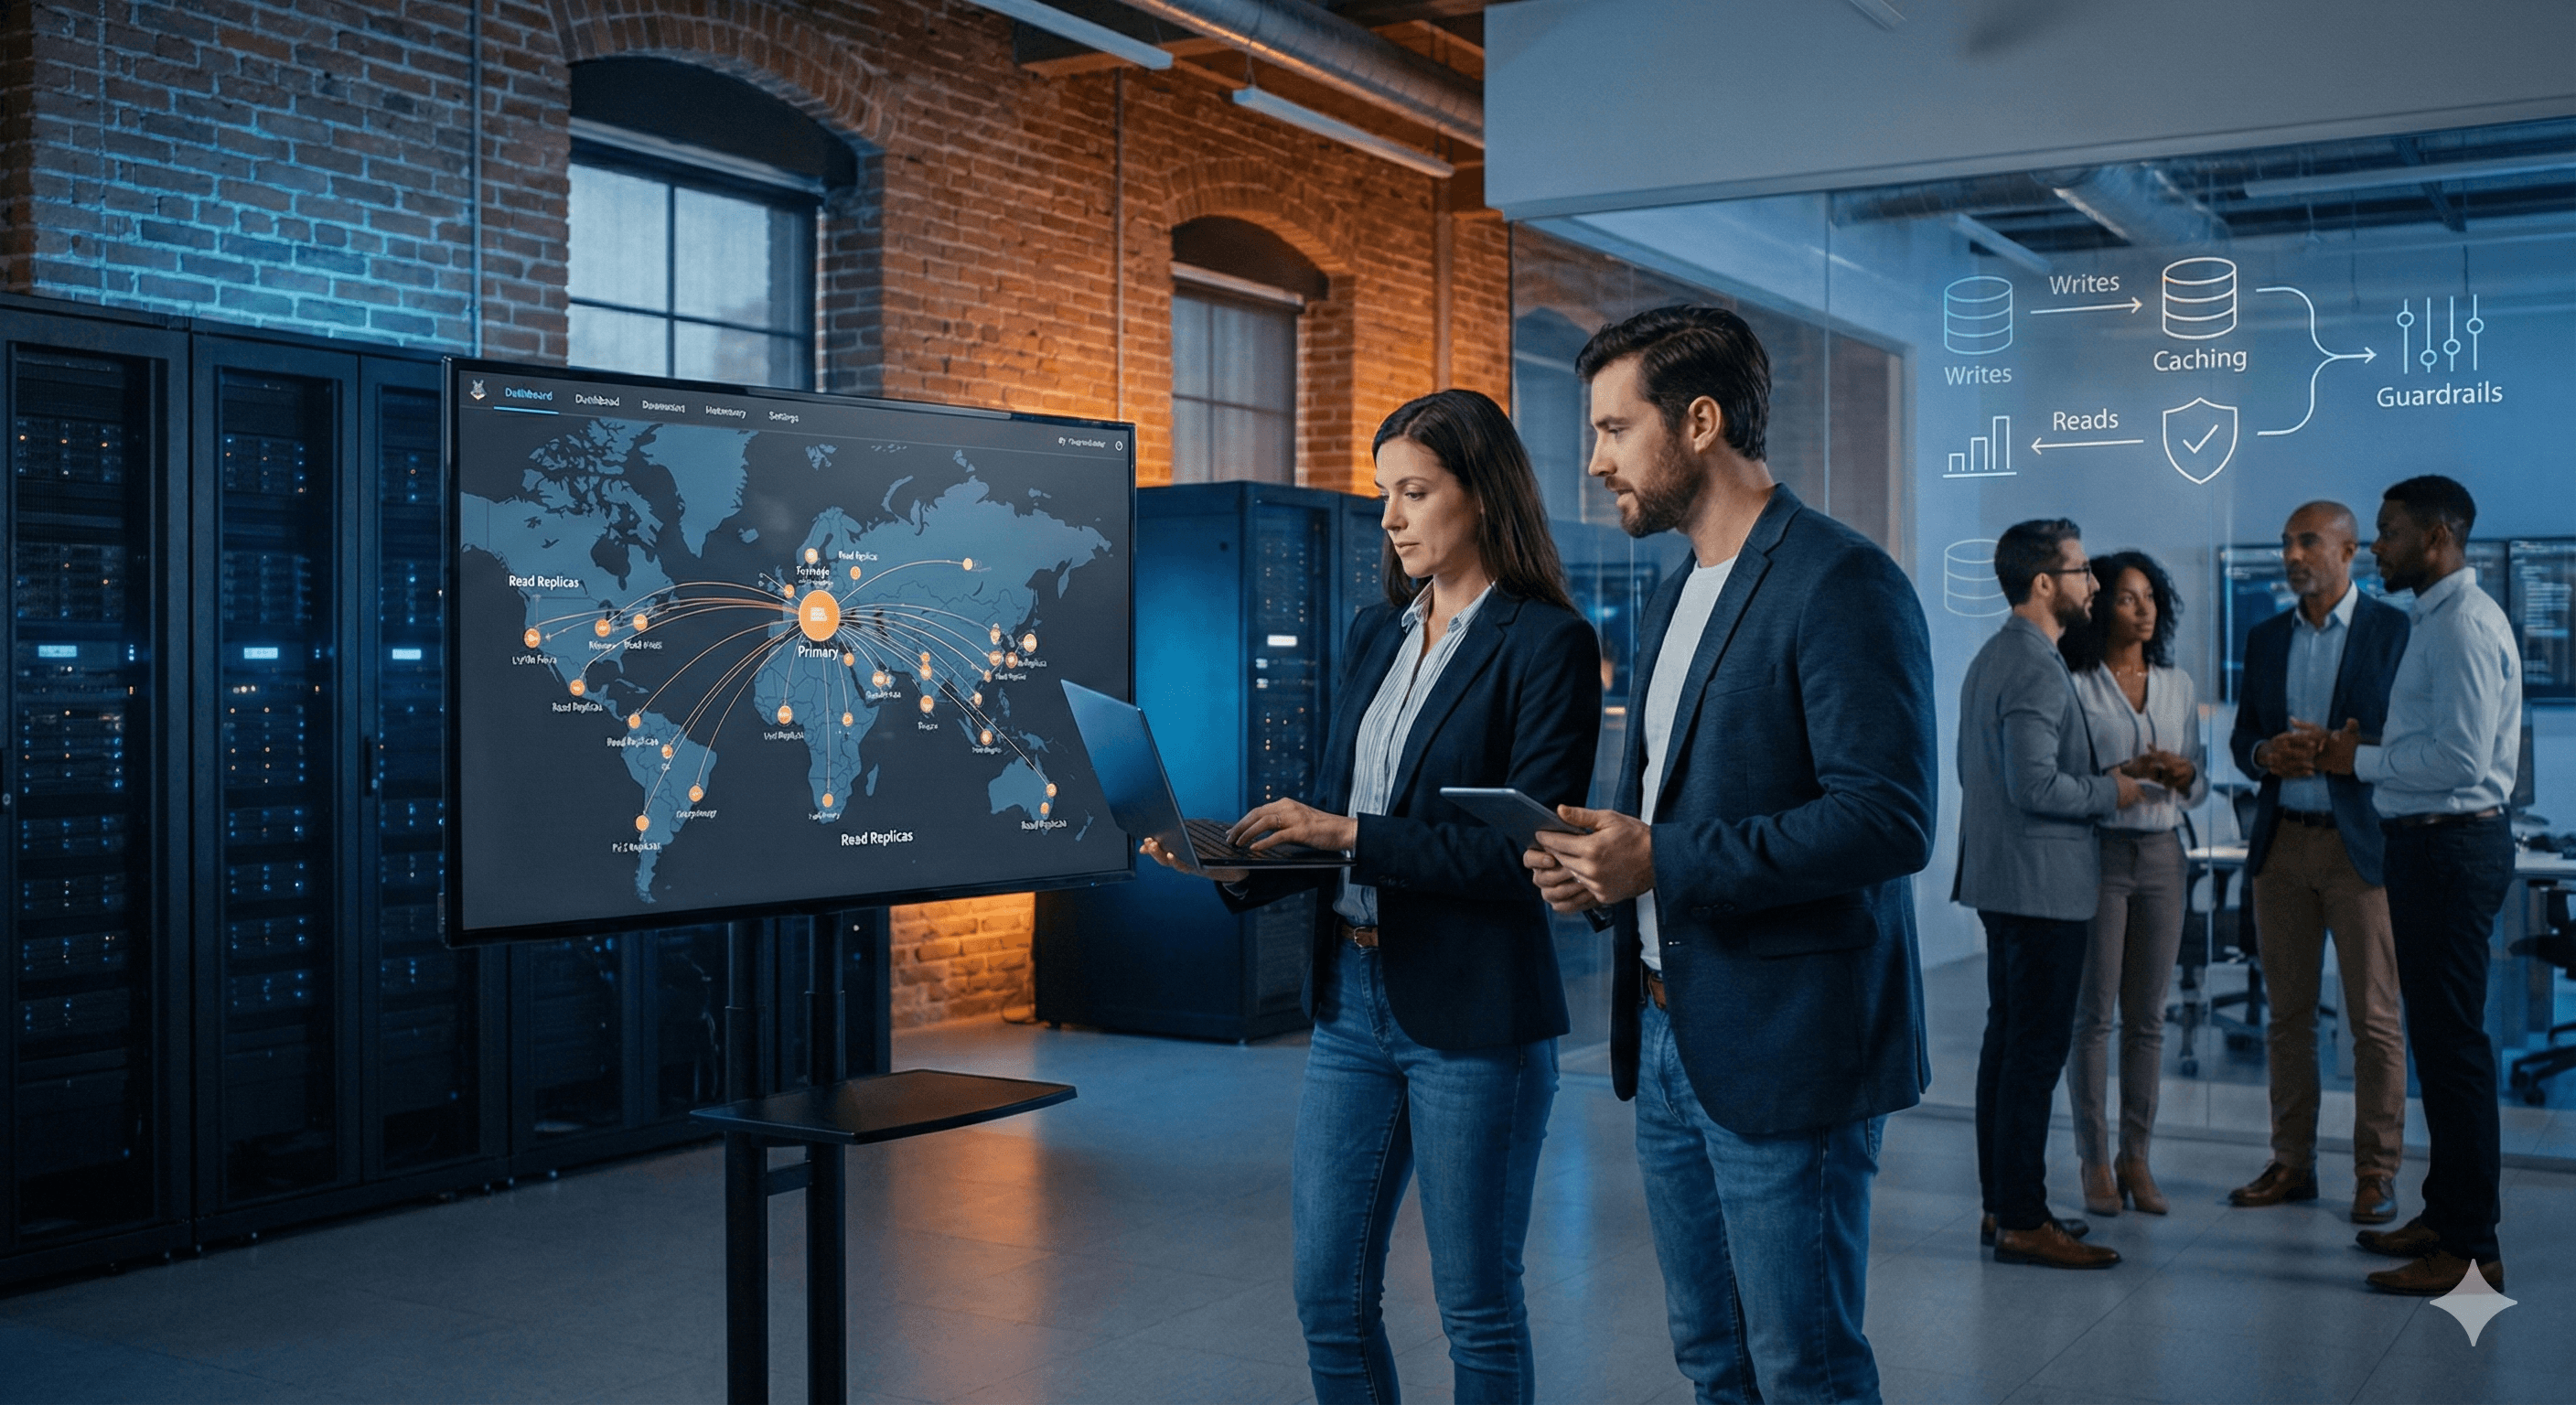
OpenAI a fait passer PostgreSQL à l'échelle pour ChatGPT en conservant une seule instance principale pour les écritures et en répartissant les lectures sur près de 50 répliques à travers différentes régions. L'équipe a réduit la pression sur la base principale grâce à la mise en cache et à l'optimisation des requêtes, a ajouté des limites de débit et l'isolation des charges de travail pour éviter les problèmes de « voisins bruyants », en plus d'imposer des règles strictes sur les modifications de schéma afin de garantir une fiabilité sans faille à grande échelle.
Gérer un produit mondial à l'échelle de ChatGPT impose une exigence faussement simple : votre base de données doit fonctionner comme un service public essentiel. Elle doit rester rapide en temps normal, prévisible lors des pointes de trafic, et se rétablir en un rien de temps lorsque quelque chose cloche en amont.
En janvier 2026, OpenAI a révélé comment ils ont poussé PostgreSQL bien au-delà de ce que la plupart des équipes croient possible : soutenir 800 millions d'utilisateurs avec une seule instance principale Azure Database for PostgreSQL qui gère les écritures, et près de 50 répliques de lecture réparties mondialement pour absorber un volume massif de requêtes de lecture.
L'architecture de base : un rédacteur, plusieurs lecteurs
Le pari fondamental d'OpenAI est tout simple : ne frappez pas de front les limites d'écriture de PostgreSQL si vous êtes capable de maintenir une charge de travail principalement axée sur la lecture.
Une seule instance principale traite toutes les écritures (gardée aussi stable et calme que possible).
Le trafic de lecture est déchargé sur les répliques dès que possible, répartissant ainsi les lectures à travers différentes zones géographiques.
Les charges de travail lourdes en écriture et partitionnables sont migrées vers des systèmes distribués (ils mentionnent Azure Cosmos DB) afin de préserver la stabilité de l'instance principale.
Le résultat, selon OpenAI : des millions de requêtes par seconde pour les charges lourdes en lecture, une latence p99 côté client sous la barre des quelques dizaines de millisecondes, et une disponibilité de 99,999 % en production.
La recette du succès en pratique (le guide de jeu)
OpenAI l'affirme sans détour : la magie ne réside pas dans l'architecture elle-même, mais bien dans les garde-fous mis en place.
1) Réduire la charge sur la base principale (sans pitié)
Ils minimisent à la fois les lectures et les écritures sur l'instance principale. Les lectures sont redirigées vers les répliques, sauf si elles doivent impérativement faire partie d'une transaction d'écriture. Quant aux écritures, elles sont allégées grâce à des corrections de bogues, à des « écritures différées » lorsque c'est pertinent, et à la migration des charges partitionnables vers d'autres systèmes.
2) Utiliser la mémoire cache pour la fiabilité, pas seulement pour la vitesse
Un scénario de panne classique qu'ils décrivent : un échec de cache (ou une panne de la couche de cache) provoque une montée soudaine de la charge sur la base de données, ce qui déclenche des délais d'attente dépassés et des tentatives en cascade. Traitez votre cache comme un pilier de stabilité, et non comme une simple optimisation facultative.
3) Optimiser les requêtes (et une bonne discipline ORM)
Ils pointent du doigt les jointures multi-tables coûteuses comme un risque récurrent (citant notamment un incident causé par une jointure de 12 tables). Leur approche : traquer et corriger en continu les modèles de requêtes inefficaces, auditer soigneusement le SQL généré par les ORM et configurer des délais d'expiration (par exemple, idle-in-transaction) pour éviter de bloquer des processus essentiels comme l'autovacuum.
4) Isoler les charges de travail : neutraliser les « voisins bruyants »
OpenAI sépare les requêtes en niveaux de priorité élevée et faible acheminés vers des instances distinctes, et applique un cloisonnement semblable entre les produits pour éviter qu'une seule fonctionnalité ne vienne ralentir l'ensemble de la plateforme.
5) Gérer le regroupement de connexions (connection pooling) pour prévenir les engorgements
Ils soulignent les limites de connexion d'Azure PostgreSQL (5 000 par instance) et les incidents passés causés par des afflux massifs et soudains de connexions. Le regroupement de connexions est géré comme une infrastructure essentielle, jamais comme une simple réflexion après coup.
6) Limiter le débit à plusieurs niveaux (et délestage ciblé)
Leur contrôle de débit s'applique à plusieurs niveaux : l'application, le gestionnaire de connexions, le proxy et les requêtes. Ils ont également la capacité de bloquer des signatures de requêtes spécifiques au besoin — très pratique pour rétablir le système rapidement lors d'une explosion de requêtes trop lourdes.
7) Gestion du schéma : « modifier un schéma, c'est un événement de production critique »
Ils évitent les changements de schéma qui forcent une réécriture complète des tables, appliquent un délai d'expiration strict de 5 secondes sur ces modifications et limitent l'ajout de nouvelles tables dans cette instance PostgreSQL (les nouveaux projets sont dirigés vers des architectures partitionnées).
Ce que cela signifie pour votre équipe
La majorité des organisations n'atteindront jamais l'échelle démesurée d'OpenAI, mais les types de pannes restent exactement les mêmes, simplement à une échelle plus modeste :
un lancement provoque une vague imprévue d'écritures
une couche de cache flanche et la base de données absorbe tout le choc
la requête lente d'un seul point de terminaison gruge tout votre processeur
les tentatives répétées transforment un simple hoquet en panne complète
La grande leçon à retenir : faire évoluer PostgreSQL dépend souvent moins de bases de données distribuées complexes que d'une belle discipline, de garde-fous solides et d'une conception intelligente des charges de travail.
Des étapes pratiques à déployer dès maintenant
Séparez délibérément les lectures et les écritures (et déterminez ce qui doit absolument toucher la base principale).
Rendez votre cache observable (la santé de votre mémoire cache doit être un indicateur d'alerte de premier ordre).
Définissez des délais maximaux pour les requêtes et les transactions, tout en surveillant activement ce que génèrent vos ORM.
Mettez en place des niveaux de priorité pour vos charges de travail (priorité haute vs basse) et isolez-les.
Appliquez des limites de débit à plusieurs couches et prévoyez une stratégie de délestage ciblée.
Considérez les modifications de schéma comme des opérations délicates encadrées par des règles strictes et des délais courts.
Comment Generation Digital peut vous aider
La mise à l'échelle n'est jamais qu'un simple défi technique de base de données : c'est avant tout une question de méthodes de travail. Nous aidons vos équipes de produit, d'ingénierie et d'opérations à s'aligner sur le modèle opérationnel idéal pour rendre ces pratiques durables et efficaces.
Et lorsque ces mêmes défis de croissance et d'éparpillement se manifestent dans vos flux de travail et de gestion du savoir, nous suggérons souvent Notion comme point d'ancrage pour structurer votre documentation, vos normes et vos gabarits réutilisables — le tout appuyé par des outils comme Asana (exécution et gouvernance) et Miro (alignement stratégique et conception). Notre objectif est le même que le vôtre : réduire les frictions, éliminer les goulets d'étranglement et bâtir des systèmes résilients qui soutiennent votre croissance.
Foire aux questions (FAQ)
Comment PostgreSQL s'en sort-il avec des volumes de requêtes aussi gigantesques?
En adaptant les lectures horizontalement grâce à des répliques, en allégeant la base principale avec de la mise en cache et des requêtes optimisées, et en appliquant des garde-fous fermes (délais d'expiration, regroupement de connexions, limites de débit) qui évitent la surcharge et les cascades de retentatives.
Qu'entend-on par « isolation des charges de travail » dans PostgreSQL?
Il s'agit de séparer les différents flux de trafic pour qu'une tâche gourmande ne pénalise pas les autres. Par exemple, en dirigeant les requêtes hautement stratégiques vers des instances dédiées pendant que les processus secondaires tournent ailleurs.
Pourquoi la limitation de débit est-elle si cruciale?
Elle permet de prévenir les pointes soudaines, les vagues de requêtes trop lourdes ou les tempêtes de relances qui risquent d'épuiser vos ressources partagées (processeur, entrées/sorties, connexions). Vos systèmes peuvent ainsi reprendre leur souffle et se rétablir rapidement sans causer de ralentissements généralisés.
Passez à l'action
Vous songez à déployer Claude ou l’IA dans toute votre organisation?
Generation Digital est fière d’être un partenaire certifié du réseau de partenaires Claude d’Anthropic. Échangez avec l’un de nos spécialistes de Claude pour planifier votre déploiement, vos formations et l’adoption de l’outil au sein de vos équipes.
Recevez chaque semaine des nouvelles et des conseils sur l'IA directement dans votre boîte de réception
En vous abonnant, vous consentez à ce que Generation Digital stocke et traite vos informations conformément à notre politique de confidentialité. Vous pouvez lire la politique complète sur gend.co/privacy.


